字符串
作者QQ:67065435 QQ群:669756510
本站内容全部为作者原创,转载请注明出处!
常用正则表达式
常用正则表达式
顶级域名
[a-z0-9_\-]+|(com|net|gov|org|edu)(\.[a-z0-9_\-]+)?)(?=$|[^a-z0-9_\-\.]

一级域名
[a-z0-9_\-]+\.((com|net|gov|org|edu)(\.[a-z0-9_\-]+)?|[a-z0-9_\-]+)(?=$|[^a-z0-9_\-\.])

日期号转日期(YYYYMMDD转YYYY-MM-DD)
(?=(\d{2}|\d{4})$)

Base64编码
^[A-Za-z0-9\+\/]+\={0,3}$

手机正则
^1[0-9]{10}$
^+861[0-9]{10}$
^+86[ |\-]1[0-9]{10}$

邮箱正则
^[a-zA-Z0-9_-]+@[a-zA-Z0-9_-]+(\.[a-zA-Z0-9_-]+)*$

手机脱敏处理
(?<=\d{3}).(?=\d{4,})

邮箱脱敏处理-全脱敏
.(?=.*@[a-zA-Z0-9_-]+(\.[a-zA-Z0-9_-]+)*$)
邮箱脱敏处理-留尾脱敏
.(?=.+@[a-zA-Z0-9_-]+(\.[a-zA-Z0-9_-]+)*$)
邮箱脱敏处理-留头脱敏
(?<=.).(?=.*@[a-zA-Z0-9_-]+(\.[a-zA-Z0-9_-]+)*$)
邮箱脱敏处理-留头留尾
(?<=.).(?=.+@[a-zA-Z0-9_-]+(\.[a-zA-Z0-9_-]+)*$)
邮箱脱敏处理-全能脱敏(M、N表示头尾各保留几位,0-∞)
(?<=.{M}).(?=.{N,}@[a-zA-Z0-9_-]+(\.[a-zA-Z0-9_-]+)*$)

汉字叠词正则表达式(红彤彤绿油油沉甸甸)
[\u4e00-\u9fa5]([\u4e00-\u9fa5])\1{1}
正则 顺序&逆序、肯定&否定 环视
顺序&逆序 肯定&否定 环视
# 注意:逆序 肯定&否定 环视,长度必须固定

# 只说明以下正则表达式元字符
1. 顺序肯定环视(?=pattern)
2. 顺序否定环视(?!pattern)
3. 逆序肯定环视(?<=pattern)
4. 逆序否定环视(?<!pattern)

# 假设有以下文本
CAT 149162536496481 DOG
Tom 149162536496481 DOG
CAT 149162536496481 Jun
Tom 149162536496481 Jun
CAT 149162536496481 DOG
Tom 149162536496481 DOG
CAT 149162536496481 Jun
Tom 149162536496481 Jun
CAT 149162536496481 DOG

# 用以下正则表达式匹配以上文本
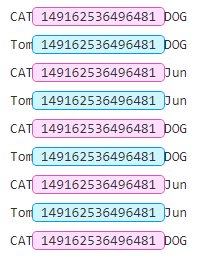
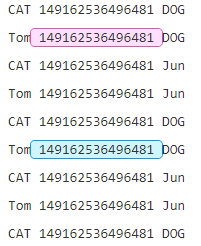
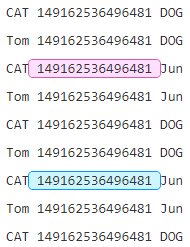
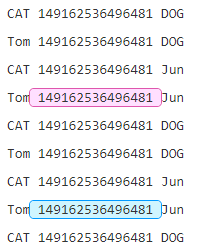
1. /\s\d+\s/g                非打印字符夹着的数字
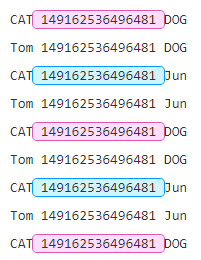
2. /(?<=CAT)\s\d+\s/g        非打印字符夹着的数字,且左侧为CAT
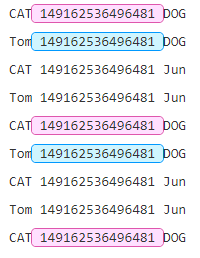
3. /\s\d+\s(?=DOG)/g         非打印字符夹着的数字,且右侧为DOG
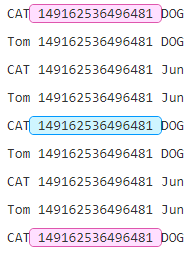
4. /(?<=CAT)\s\d+\s(?=DOG)/g 非打印字符夹着的数字,且左侧为CAT,右侧为DOG
5. /(?<!CAT)\s\d+\s(?=DOG)/g 非打印字符夹着的数字,且左侧不为CAT,右侧为DOG
6. /(?<=CAT)\s\d+\s(?!DOG)/g 非打印字符夹着的数字,且左侧为CAT,右侧不为DOG
7. /(?<!CAT)\s\d+\s(?!DOG)/g 非打印字符夹着的数字,且左侧不为CAT,右侧不为DOG
将分别得到以下匹配结果(从截图可以看出,环视不会获取字符,只进行匹配)
正则对敏感词进行分类屏蔽
- php敏感词屏蔽
<?php
$input = __DIR__ . "/input.txt";
$str = file_get_contents($input);
//敏感词先分3类
$bds1 = '/a|b|c/';
$bds2 = '/d|e|f/';
$bds3 = '/g|h|i/';
$str = preg_replace($bds1,'*',$str);
$str = preg_replace($bds2,'#',$str);
$str = preg_replace($bds3,'?',$str);
echo $str;
正则替换且保留匹配字符
- php正则替换保留匹配字符
<?php
//用一次preg_replace,将英文字符串加上b标签
//“\0”表示主匹配字符串,替换后将保持不变
$html = <<<HTML
中文汉字ABC中文汉字ADG中文汉字HJL中文汉字
中文汉字ABC中文汉字ADG中文汉字HJL中文汉字
中文汉字ABC中文汉字ADG中文汉字HJL中文汉字
中文汉字ABC中文汉字ADG中文汉字HJL中文汉字
HTML;
echo preg_replace("/[A-Za-z]+/u","<b>\\0</b>",$html);
#pattern# 与 /pattern/ 的区别
- “#”包裹的正则表达式不转译pattern内的“/”字符,“/”包裹的正则表达式要转译pattern内的“/”为“\/”
# 例如
#[A-Za-z0-9/]+# 等价于 /[A-Za-z0-9\/]+/
判断字符串是否为邮箱、URL、邮编等
php字符串类型判断
<?php
# 判断一个变量是否为整数、小数、布尔值
$str = '123456789';
$is_rule = filter_var($str, FILTER_VALIDATE_INT);
$is_rule = filter_var($str, FILTER_VALIDATE_FLOAT);
$is_rule = filter_var($str, FILTER_VALIDATE_BOOLEAN);

# 判断一个变量是否为IP地址、IPv4地址、IPv6地址、MAC地址、URL、邮箱
$str = '123456789@qq.com';
$is_ip = filter_var($str, FILTER_VALIDATE_IP);
$is_ip = filter_var($str, FILTER_VALIDATE_IP, FILTER_FLAG_IPV4);
$is_ip = filter_var($str, FILTER_VALIDATE_IP, FILTER_FLAG_IPV6);
$is_mac = filter_var($str, FILTER_VALIDATE_MAC);
$is_url = filter_var($str, FILTER_VALIDATE_URL);
$is_email = filter_var($str, FILTER_VALIDATE_EMAIL);

# 判断一个邮箱域名是否可用
$domain = 'qq.com';
$have_mx = checkdnsrr($domain, 'MX');
根据设备标识获取设备类型
php判断设备信息
<?php
$alibaba = '/alipayclient/';
$wechat = '/micromessenger/';
$phone = '/android|webos|iphone|ipad|ipod|blackberry|symbianos|windows phone/';

$use_agent = strtolower($_SERVER['HTTP_USER_AGENT']);

if(preg_match($alibaba, $use_agent)){
    echo '支付宝';
} elseif(preg_match($wechat, $use_agent)){
    echo '微信';
} elseif (preg_match($phone, $use_agent)) {
    echo '手机';
}else {
    echo '电脑';
}
判断身份证号是否为合规的身份证号
- php判断四代身份证最后一位是否正确
<?php
$sum = 0;
$id_num = '13333320001111222x';
$pow = [7, 9, 10, 5, 8, 4, 2, 1, 6, 3, 7, 9, 10, 5, 8, 4, 2];
for ($i = 0; $i < 17; $i++) {
   $num = (int)substr($id_num, $i, 1);
   $sum += $num * $pow[$i];
}
$end = (12 - ($sum % 11)) % 11;
$end = $end < 10 ? (string)$end : 'x';
echo $end;
IP相关的字符串处理
php获取与服务器直接通信的客户端IP
<?php
function getIP() {
    return $_SERVER['REMOTE_ADDR'];
}
IPv4与数字进行转换
<?php
echo long2ip(16843009);
echo ip2long("1.1.1.1");
编码相关的字符串处理
PHP字符串转UTF-8
<?php
$input = __DIR__ . "/input.txt";
$str = file_get_contents($input);
$encode = mb_detect_encoding($str, ["ASCII", "GB2312", "GBK", "UTF-8"]);
$str = mb_convert_encoding($str, "UTF-8", $encode);
echo $str;
php输出随机中文
<?php
$length = 3;
$unicode = "";
for ($i = 1; $i <= $length; $i++) {
    $number = rand(0x4e00, 0x9fa5);
    $number = dechex($number);
    $unicode .= "\\u{$number}";
}
$chinese = json_decode("[\"{$unicode}\"]", true);
$chinese = $chinese[0];
echo $chinese;
php输出自定义名称
<?php
//随机获取姓氏
$last_name = ["赵","钱","孙","李","周","吴","郑","王","冯","陈","褚","卫","蒋","沈","韩","杨","朱","秦","尤","许","何","吕","施","张","孔","曹","严","华","金","魏","陶","姜","戚","谢","邹","喻","柏","水","窦","章","云","苏","潘","葛","奚","范","彭","郎","鲁","韦","昌","马","苗","凤","花","方","俞","任","袁","柳","酆","鲍","史","唐","费","廉","岑","薛","雷","贺","倪","汤","滕","殷","罗","毕","郝","邬","安","常","乐","于","时","傅","皮","卞","齐","康","伍","余","元","卜","顾","孟","平","黄","和","穆","萧","尹","姚","邵","湛","汪","祁","毛","禹","狄","米","贝","明","臧","计","伏","成","戴","谈","宋","茅","庞","熊","纪","舒","屈","项","祝","董","梁","杜","阮","蓝","闵","席","季","麻","强","经","房","裘","缪","干","解","应","宗","丁","宣","贲","邓","郁","单","杭","洪","包","诸","左","石","崔","吉","钮","龚","程","嵇","邢","滑","裴","陆","荣","翁","荀","羊","於","惠","甄","曲","家","封","芮","羿","储","靳","汲","邴","糜","松","井","段","富","巫","乌","焦","巴","弓","牧","隗","山","谷","车","侯","宓","蓬","全","郗","班","仰","秋","仲","伊","宫","宁","仇","栾","暴","甘","钭","厉","戎","祖","武","符","刘","景","詹","束","龙","索","咸","籍","赖","卓","蔺","屠","蒙","池","乔","阴","郁","胥","能","苍","双","闻","莘","党","翟","谭","贡","劳","逄","姬","申","扶","堵","冉","宰","郦","雍","却","璩","桑","桂","濮","牛","寿","通","边","扈","燕","冀","郏","浦","尚","农","温","别","庄","晏","柴","瞿","阎","充","慕","连","茹","习","宦","艾","鱼","容","向","古","易","慎","戈","廖","庾","终","暨","居","衡","步","都","耿","满","弘","匡","国","文","寇","广","禄","阙","东","欧","殳","沃","利","蔚","越","夔","隆","师","巩","厍","聂","晁","勾","敖","融","冷","訾","辛","阚","那","简","饶","空","曾","毋","沙","乜","养","鞠","须","丰","巢","关","蒯","相","查","后","荆","红","游","竺","权","逯","盖","益","桓","公","闻人","东方","赫连","皇甫","尉迟","公羊","东郭","南门","呼延","归","海","羊舌","微生","岳","帅","缑","亢","况","郈","有","琴","梁丘","左丘","东门","西门","商","牟","佘","佴","伯","赏","南宫","墨","哈","谯","笪","年","爱","阳","佟","第五","言","福"];
$last_name = $last_name[rand(0, count($last_name) - 1)];

//随机获取字辈
$center_name = "伯伟尚嘉芳浩天大发祥闻知尊典训正直集材梁礼义为贤度谦恭有道光齐家先孝友之国尚文章学问通经济功名奏天堂祖训欣永振百世受其昌";
$center_name = mb_substr($center_name, rand(0, mb_strlen($center_name) - 1), 1);

//随机获取名字
$first_name = "涛昌进林有坚和彪博诚先敬震振壮会群豪心邦承乐绍功松善厚庆磊民友裕河哲江超浩亮政谦亨奇固之轮翰朗伯宏言若鸣朋斌梁栋维启克伦翔旭鹏泽晨辰士以建家致树炎德行时泰盛雄琛钧冠策腾伟刚勇毅俊峰强军平保东文辉力明永健世广志义兴良海山仁波宁贵福生龙元全国胜学祥才发成康星光天达安岩中茂武新利清飞彬富顺信子杰楠榕风航弘男女嘉琼桂娣叶璧璐娅琦晶妍茜秋珊莎锦黛青倩婷姣婉娴瑾颖露瑶怡婵雁蓓纨仪荷丹蓉眉君琴蕊薇菁梦岚苑婕馨瑗琰韵融园艺咏卿聪澜纯毓悦昭冰爽琬茗羽希宁欣飘育滢馥筠柔竹霭凝晓欢霄枫芸菲寒伊亚宜可姬舒影荔枝思丽秀娟英华慧巧美娜静淑惠珠翠雅芝玉萍红娥玲芬芳燕彩春菊勤珍贞莉兰凤洁梅琳素云莲真环雪荣爱妹霞香月莺媛艳瑞凡佳";
$first_name = mb_substr($first_name, rand(0, mb_strlen($first_name) - 1), 1);

echo "{$last_name}{$first_name}";
echo "{$last_name}{$center_name}{$first_name}";
php章节内容转html可显示的unicode(10进制码)
<?php
function unicode_encode($from_str = "", $zone = "")
{
    if (empty($from_str)) {
        return "";
    }
    if ($zone == 'zh_cn') {
        //$pattern = '/[一-龥]{1}/u';
        $pattern = '/[\x{4e00}-\x{9fa5}]{1}/u';
    } elseif ($zone == 'en_uf') {
        $pattern = '/[A-Za-z]{1}/u';
    } else {
        $pattern = '/./u';
    }
    preg_match_all($pattern, $from_str, $search);
    $replace = [];
    $search = $search[0];
    $search = array_unique($search);
    foreach ($search as $s) {
        $replace[] = "&#" . hexdec(bin2hex(mb_convert_encoding($s, "UCS-4"))) . ";";
    }
    $res_str = str_replace($search, $replace, $from_str);
    unset($search, $replace);
    return $res_str;
}
//全部转换
echo unicode_encode("大家好,我叫PHP");
//只转中文
echo unicode_encode("大家好,我叫PHP", 'zh_cn');
//只转英文
echo unicode_encode("大家好,我叫PHP", 'en_uf');
php章节内容格式整理
<?php
//获取输入文本
$input = __DIR__ . "/input.txt";
$str = @file_get_contents($input);
//处理输入文本
$str = preg_replace("/[^\\S\\r\\n]+/", " ", $str);
$str = preg_replace("/[\\s]*[\\r\\n]+[\\s]*/", "\r\n", $str);
$str = preg_replace("/[\\r\\n]+/", "\r\n", $str);
$str = trim($str);
//保存输出文本
$output = __DIR__ . "/output.txt";
file_put_contents($output, $str);
php章节异常换行整理
<?php
$input = __DIR__ . "/input.txt";
$output = __DIR__ . "/output.txt";
$str = @file_get_contents($input);
$pattern = '/[\x{4e00}-\x{9fa5}\,;\'",;‘“]{1}[\r\n]+/u';
preg_match_all($pattern, $str, $matches);
$matches = $matches[0];
$matches = array_unique($matches);
foreach ($matches as $match) {
    $str = str_replace(
        $match,
        preg_replace('/[\r\n]+/', '', $match),
        $str
    );
}
file_put_contents($output, $str);
内容阅读相关的字符串处理
php书籍文本格式处理为文本
<?php
$input = __DIR__ . "/input.txt";
$output = __DIR__ . "/output.txt";
$type = 0;//0-默认章名 1-数字章名 2-井号章名
$str = file_get_contents($input);
$regular = "第([0-9]+|[零〇0一壹二贰两三叁四肆五伍六陆七柒八捌九玖十拾百佰千仟万萬]+)(卷|章|话|回|节)";
$str = ltrim($str, "\xEF\xBB\xBF");
$encode = mb_detect_encoding($str, ["ASCII", "GB2312", "GBK", "UTF-8"]);
$str = mb_convert_encoding($str, "UTF-8", $encode);
$str = preg_replace("/[^\\S\\r\\n]+/", " ", $str);
$str = preg_replace("/[\\s]*[\\r\\n]+[\\s]*/", "\r\n", $str);
$str = preg_replace("/[\\r\\n]+/", "\r\n", $str);
if ($type === 1) {
    $str = preg_replace("/^[0-9]+|[\\r\\n]+[0-9]+/", "\r\n第1章", $str);
} elseif ($type === 2) {
    $str = preg_replace("/(^[#]+|[\\r\\n]+[#]+)+($regular)?/", "\r\n第1章", $str);
}
$str = preg_replace("/^(.*?)$regular/", "第1章", $str);
$str = preg_replace("/[\\r\\n]+[^\x{4E00}-\x{95A5}0-9A-Za-z《〈“‘【(<\"'\[({]*$regular/u", "\r\n第1章", $str);
$str = preg_replace("/(第1(卷|章|话|回|节)(.*?)[\r\n]+)+第1(卷|章|话|回|节)/", "第1章", $str);
file_put_contents($output, $str);
php书籍文本格式处理为数组
<?php
$input = __DIR__ . "/input.txt";
$type = 0;//0-默认章名 1-数字章名 2-井号章名
$start = 0;//跳过了多少个章节(新章节序号为 $start + 1)
$regular = "第([0-9]+|[零〇0一壹二贰两三叁四肆五伍六陆七柒八捌九玖十拾百佰千仟万萬]+)(卷|章|话|回|节)";
$str = file_get_contents($input);
$str = ltrim($str, "\xEF\xBB\xBF");
$encode = mb_detect_encoding($str, ["ASCII", "GB2312", "GBK", "UTF-8"]);
$str = mb_convert_encoding($str, "UTF-8", $encode);
$str = preg_replace("/[^\\S\\r\\n]+/", " ", $str);
$str = preg_replace("/[\\s]*[\\r\\n]+[\\s]*/", "\r\n", $str);
$str = preg_replace("/[\\r\\n]+/", "\r\n", $str);
if ($type === 1) {
    $str = preg_replace("/^[0-9]+|[\\r\\n]+[0-9]+/", "\r\n第1章", $str);
} elseif ($type === 2) {
    $str = preg_replace("/(^[#]+|[\\r\\n]+[#]+)+($regular)?/", "\r\n第1章", $str);
}
$str = preg_replace("/^(.*?)$regular/", "第1章", $str);
$str = preg_replace("/[\\r\\n]+[^\x{4E00}-\x{95A5}0-9A-Za-z《〈“‘【(<\"'\[({]*$regular/u", "\r\n第1章", $str);
$str = preg_replace("/(第1(卷|章|话|回|节)(.*?)[\r\n]+)+第1(卷|章|话|回|节)/", "第1章", $str);

$cname = "第([0-9]+|[零〇0一壹二贰两三叁四肆五伍六陆七柒八捌九玖十拾百佰千仟万萬]+)(卷|章|话|回|节)(.*?)[\\r\\n]+";

preg_match_all("/$cname/", $str, $chanter_names, PREG_PATTERN_ORDER, 0);
$chanter_names = $chanter_names[0];
$total_names = count($chanter_names);

$chanter_contents = preg_split("/$cname/", $str, null);
array_shift($chanter_contents);
$total_contents = count($chanter_contents);

$chapters = [];
if ($total_names === $total_contents) {
    foreach ($chanter_names as $key => $chanter_name) {
        $chapter_order = $key + $start + 1;
        $chanter_name = preg_replace("/[^\S]+/", "", $chanter_name);
        $chanter_name = str_replace("第1章", "第{$chapter_order}章 ", $chanter_name);
        $chapters[] = [
            'chapter_order' => $key + 1,
            'chapter_name' => $chanter_name,
            'chapter_content' => $chanter_contents[$key]
        ];
    }
}
print_r($chapters);